Kolejne strony listy wpisów, realizacji czy wątków na forum są dla Google osobnymi stronami i tak należy je ustawić: każda z własnym adresem, własnym adresem kanonicznym i zwykłymi odnośnikami do sąsiednich stron. Poniżej opisujemy, jak to zrobić od strony technicznej, dlaczego kierowanie wszystkiego na pierwszą stronę jest błędem i co zostało z dawnych znaczników prev i next.
Jak Google traktuje strony 2, 3 i dalsze
Google traktuje każdy adres w sekwencji stron jako odrębną stronę. Tak stanowi dokumentacja Centrum wyszukiwarki Google poświęcona podziałowi na strony i przyrostowemu wczytywaniu. Nie istnieje więc żaden specjalny tryb, w którym wyszukiwarka skleja strony od pierwszej do ostatniej w jedną całość. Strona trzecia archiwum bloga jest skanowana, oceniana i indeksowana tak samo jak każda inna podstrona serwisu.
Z tego jednego zdania wynika niemal wszystko, co dalej opisujemy. Skoro strona druga jest samodzielną stroną, to musi mieć swój adres, pod którym zawsze widać tę samą część listy. Skoro jest samodzielna, to nie jest kopią strony pierwszej i nie należy jej tak oznaczać. I skoro robot ma do niej trafić, to musi prowadzić do niej odnośnik, który robot potrafi odczytać.
Choć dokumentacja znajduje się w dziale przeznaczonym dla sklepów, Google wymienia w niej wprost także inne miejsca, w których stosuje się podział na strony: wyniki wyszukiwania w serwisie, strony kategorii, listy wpisów na blogu i archiwa newsletterów, opinie o produktach oraz komentarze pod wpisami. Te same zasady obowiązują zatem bloga firmowego, dział aktualności urzędu, forum branżowe i listę realizacji firmy budowlanej.
Podział długiej listy elementów na kolejne strony, z których każda pokazuje tylko jej część. W polskiej dokumentacji Google występuje pod nazwą „podział na strony”.
Warto też rozumieć, po co kolejne strony w ogóle istnieją z punktu widzenia wyszukiwarki. Rzadko chodzi o to, żeby strona siódma archiwum pojawiała się w wynikach. Jej zadanie jest inne: to przez nią robot dociera do starszych wpisów, opisów realizacji albo wątków, do których nie prowadzi żadna inna droga. Dalsze strony listy są więc przede wszystkim korytarzem, a dopiero w drugiej kolejności stroną docelową. O tym, jak przebiega skanowanie i indeksowanie, piszemy w osobnym wpisie.
Listy produktów mają swoją specyfikę: filtry, sortowanie, wybór między numerowanymi stronami a przyciskiem doładowania. Tym tematem zajmuje się wpis o paginacji w sklepie internetowym. Tutaj skupiamy się na warstwie technicznej wspólnej dla wszystkich rodzajów serwisów.
Jakie adresy nadać kolejnym stronom
Każda strona sekwencji powinna mieć własny, unikalny adres, a najprostszym sposobem jest parametr zapytania z numerem strony, który Google podaje jako przykład w postaci ?page=n. Równie dobrze sprawdza się numer w ścieżce adresu. W WordPressie przy włączonych przyjaznych odnośnikach kolejne strony archiwum mają zwykle postać z członem /page/2/. Obie formy spełniają ten sam warunek: numer strony jest częścią adresu, który serwer rozumie i na który odpowiada inną treścią.
https://www.example.com/blog/?page=3
https://www.example.com/blog/page/3/
Dlaczego numer strony nie może stać po krzyżyku
Google ignoruje identyfikatory fragmentów, czyli wszystko, co w adresie stoi po znaku #. Dokumentacja ostrzega, że jeśli odnośnik do następnej strony różni się od bieżącego adresu tylko fragmentem, robot może nim nie podążyć, uznając, że tę stronę już pobrał. Adres zakończony na #strona-2 jest dla wyszukiwarki tym samym adresem co wersja bez tego dopisku. Taka konstrukcja zdarza się w serwisach, w których lista jest doładowywana skryptem, i w praktyce oznacza, że Google widzi wyłącznie pierwszą porcję treści.
Stała zawartość pod danym adresem
Adres strony powinien za każdym razem pokazywać tę samą część listy. Google opisuje to przy okazji przewijania nieskończonego w dokumencie o leniwie ładowanej zawartości: zaleca bezwzględne numery stron, takie jak ?page=12, i odradza adresy względne w rodzaju ?date=yesterday, pod którymi jutro będzie już coś innego. W blogu i w aktualnościach pełnej stałości nie da się osiągnąć, bo każdy nowy wpis przesuwa starsze o jedno miejsce. Jest to zjawisko naturalne. Chodzi o to, żeby nie dokładać do niego własnych zmiennych, na przykład kolejności losowej albo zależnej od tego, kto ogląda stronę.
Pierwsza strona pod dwoma adresami
Częstym niedopatrzeniem jest dostępność pierwszej strony pod dwoma adresami: głównym adresem listy oraz wersją z numerem jeden, na przykład ?page=1. To już prawdziwy duplikat, bo oba adresy pokazują identyczną treść. Dokumentacja Google o konsolidacji zduplikowanych adresów wskazuje, że najsilniejszym sygnałem jest przekierowanie, a kolejnym adnotacja rel="canonical". Z naszej praktyki wynika, że najczyściej jest przekierować wersję z jedynką na adres główny i zadbać, żeby odnośnik „1” w nawigacji prowadził wprost do adresu głównego. Ogólne zasady budowania adresów omawiamy we wpisie o strukturze adresów URL.
Dlaczego nie kierować adresu kanonicznego na pierwszą stronę
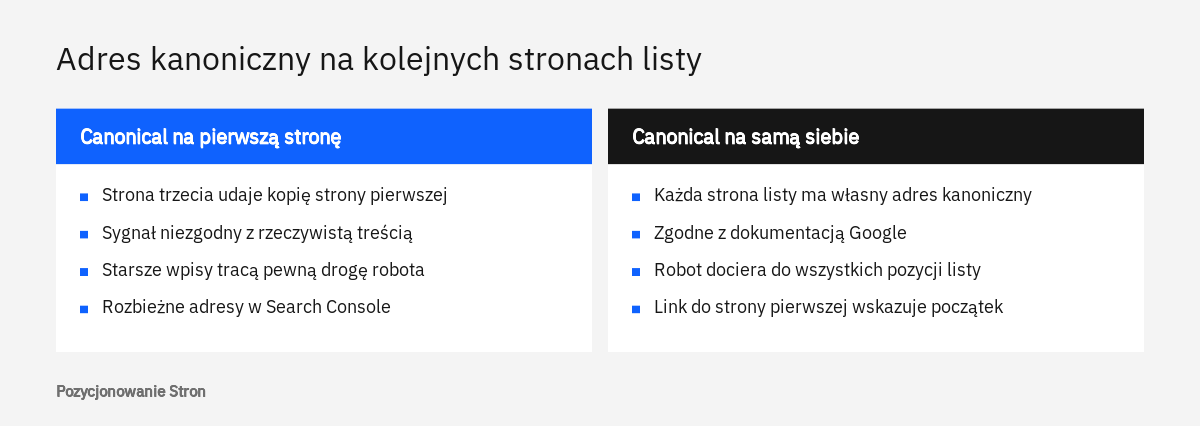
Adres kanoniczny każdej strony w sekwencji powinien wskazywać na nią samą, ponieważ strona druga nie jest kopią strony pierwszej. Google mówi o tym wprost: pierwszej strony sekwencji nie należy używać jako strony kanonicznej dla pozostałych, a każda strona ma mieć własny adres kanoniczny.
Źródłem pomyłki jest błędne rozumienie samego mechanizmu. Adnotacja rel="canonical" służy do wskazania preferowanego adresu wśród stron o tej samej lub bardzo podobnej treści. Strona czwarta archiwum bloga pokazuje jednak inne wpisy niż strona pierwsza. Łączy je szablon, nagłówek i stopka, ale właściwa zawartość, czyli lista odnośników do wpisów, jest odmienna. Oznaczenie jej jako duplikatu pierwszej strony jest po prostu nieprawdziwe.
Skutki takiego ustawienia bywają dwojakie. Jeśli Google zastosuje się do wskazówki, uzna dalsze strony za wersje alternatywne i skupi się na stronie pierwszej, a wtedy wpisy i realizacje dostępne wyłącznie z dalszych stron tracą pewną drogę dotarcia robota. Jeśli zaś uzna wskazówkę za błędną, wybierze adres kanoniczny samodzielnie, a właściciel serwisu zobaczy w Search Console rozbieżność między tym, co zadeklarował, a tym, co wybrała wyszukiwarka. W obu przypadkach serwis wysyła sygnał sprzeczny z rzeczywistością.
<!-- błąd: trzecia strona udaje kopię pierwszej -->
<link rel="canonical" href="https://www.example.com/blog/">

<!-- poprawnie: trzecia strona wskazuje samą siebie -->
<link rel="canonical" href="https://www.example.com/blog/?page=3">
Przy wdrożeniu obowiązują te same zasady co w całym serwisie. Google zaleca pełne, bezwzględne adresy zamiast ścieżek względnych oraz jedną metodę podania adnotacji: albo w kodzie HTML, albo w nagłówku HTTP. Odradza też wskazywanie jako kanonicznego adresu z fragmentem po krzyżyku. Jeżeli lista jest składana skryptem w przeglądarce, adnotacja powinna znajdować się w źródłowym kodzie HTML i nie być później podmieniana. Szczegóły opisujemy we wpisie o tym, jak poprawnie wdrożyć adres kanoniczny.
Paginacja to nie to samo co sortowanie i filtry
Inaczej wygląda sprawa z adresami, które pokazują tę samą listę w innym układzie. Google zwraca uwagę, że filtry i alternatywne sposoby sortowania, na przykład parametr ?order=price, tworzą powielone wersje tej samej listy, i radzi wyłączyć je z indeksu tagiem noindex albo zablokować ich skanowanie w pliku robots.txt na podstawie wzorca adresu. W blogu odpowiednikiem bywa sortowanie wpisów od najstarszych lub według popularności. To rozróżnienie jest kluczowe: strona trzecia listy jest nową treścią, a ta sama lista ułożona odwrotnie jest powtórzeniem. Więcej o tym w naszym wpisie o sortowaniu i parametrach w adresach.
Czy wyłączać dalsze strony z indeksu
Dokumentacja Google dotycząca podziału na strony nie zaleca wyłączania kolejnych stron listy z indeksu. Tag noindex pojawia się w niej tylko przy wariantach sortowania i filtrach. Decyzję o oznaczeniu nim stron drugiej i dalszych trzeba więc podjąć samodzielnie, ze świadomością tego, co ten tag robi, a czego nie robi.
Według dokumentu o blokowaniu indeksowania tagiem noindex strona z tą regułą jest całkowicie usuwana z wyników wyszukiwania. Żeby reguła zadziałała, robot musi ją odczytać, dlatego strona nie może być jednocześnie zablokowana w pliku robots.txt. Po dodaniu tagu zmiana staje się widoczna dopiero po kolejnej wizycie robota, co według Google może zająć nawet kilka miesięcy.
Drugi fakt często zaskakuje: noindex nie oszczędza zasobów skanowania. W materiale o optymalizacji budżetu indeksowania Google wyjaśnia, że robot i tak wysyła żądanie do takiej strony, a dopiero po odczytaniu tagu ją pomija. Argument „wyłączamy dalsze strony, żeby robot nie tracił na nie czasu” nie ma więc oparcia w źródle. Ten sam dokument zastrzega zresztą, że jest przeznaczony dla dużych serwisów: orientacyjnie powyżej miliona unikalnych stron przy treści zmienianej raz w tygodniu albo powyżej 10 tys. stron przy treści zmienianej codziennie. Blog firmowy z kilkudziesięcioma stronami archiwum nie należy do tej grupy. Zagadnienie rozwijamy we wpisie o budżecie indeksowania.
Trzecia sprawa dotyczy odnośników. Dokumentacja nie opisuje, jak Google traktuje linki umieszczone na stronie z tagiem noindex, więc nie mamy podstaw, by twierdzić, że robot zawsze będzie nimi podążał. Skoro głównym zadaniem dalszych stron jest doprowadzenie robota do starszych treści, pozbawianie ich miejsca w indeksie oznacza przyjęcie ryzyka, którego nie da się oszacować na podstawie źródeł. Z naszej praktyki wynika, że bezpieczniej jest zostawić te strony indeksowalne, a jeśli właściciel serwisu mimo wszystko chce je wyłączyć, najpierw zapewnić starszym treściom inne dojścia: mapę witryny, strony kategorii, odnośniki z nowszych wpisów.
Kiedy wyłączenie z indeksu bywa uzasadnione? Wtedy, gdy stronicowana lista sama w sobie nie powinna być w wynikach, a treści, do których prowadzi, są dostępne inną drogą. Typowym przykładem są wyniki wewnętrznej wyszukiwarki serwisu albo archiwa autorów w blogu prowadzonym przez jedną osobę, które powielają główną listę wpisów. Różnice między poszczególnymi narzędziami wyjaśniamy we wpisie canonical, noindex i robots.txt.
Jeśli chcą Państwo zamówić pozycjonowanie sklepu internetowego, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Jak połączyć strony odnośnikami
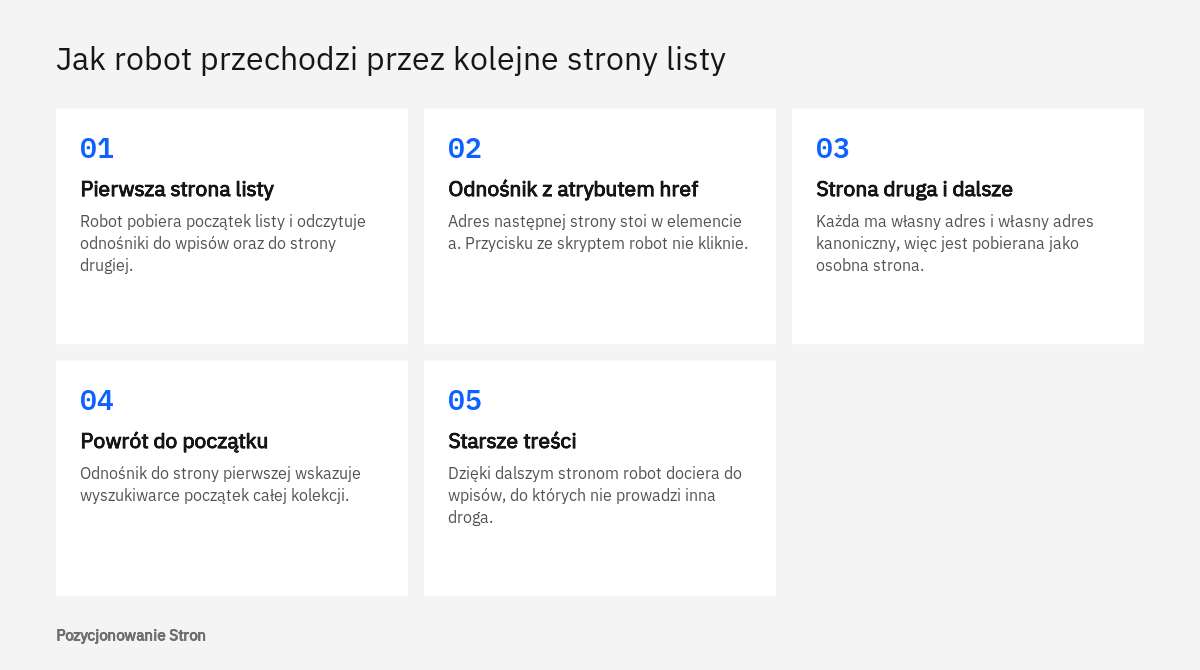
Strony listy należy połączyć zwykłymi odnośnikami, czyli elementami a z atrybutem href, tak aby z każdej strony dało się przejść do następnej. Google wyjaśnia, że robot odkrywa adresy głównie w ten sposób, nie klika przycisków i zazwyczaj nie uruchamia skryptów, które wymagają działania użytkownika.
Dokument o sprawdzonych metodach dotyczących linków precyzuje, co wyszukiwarka uznaje za odnośnik. Adres jest odczytywany z elementu a, który ma atrybut href. Element bez tego atrybutu, obsługiwany wyłącznie zdarzeniem onclick, nie jest analizowany, a zapis z pseudoadresem zaczynającym się od javascript: jest odradzany. Nawigacja zbudowana z elementów button albo span może więc działać bez zarzutu dla czytelnika i jednocześnie być dla robota ślepą uliczką.
<!-- czytelne dla robota -->
<nav aria-label="Strony listy wpisów">
  <a href="/blog/">1</a>
  <a href="/blog/?page=2">2</a>
  <a href="/blog/?page=3">3</a>
  <a href="/blog/?page=3">Następna strona</a>
</nav>

<!-- nieczytelne: brak atrybutu href -->
<span onclick="wczytaj(3)">Następna strona</span>
Odnośnik do pierwszej strony
Google zaleca również, aby z każdej strony sekwencji prowadził odnośnik do strony pierwszej. Ma to zaznaczyć początek kolekcji i dać wyszukiwarce wskazówkę, że pierwsza strona może być lepszą stroną docelową niż pozostałe. W praktyce wystarcza cyfra „1” w nawigacji albo okruszki z nazwą listy. W ten sposób bez żadnych adnotacji kanonicznych osiąga się cel, który wiele osób próbuje wymusić błędnym canonicalem: wyszukiwarka dostaje jasny sygnał, która strona jest główna.
Przycisk doładowania i przewijanie nieskończone
Przycisk dokładający kolejne pozycje oraz przewijanie nieskończone są zwykle realizowane skryptem, dlatego wymagają równoległej ścieżki z prawdziwymi adresami. Google podaje warunki: każda porcja treści ma własny, trwały adres, odnośniki do tych adresów są ułożone po kolei, a gdy po przewinięciu nowa porcja staje się głównym widocznym elementem, adres w pasku przeglądarki jest aktualizowany za pomocą History API, czyli interfejsu przeglądarki do zmiany adresu bez przeładowania strony.
Jako dodatkowe zabezpieczenie Google wskazuje mapę witryny, która pomaga odnaleźć wszystkie pozycje listy. Jest ona jednak słabym sygnałem i nie zastępuje odnośników wewnętrznych. O jej budowie piszemy we wpisie o mapie witryny XML.
Co zostało ze znaczników rel next i rel prev
Google nie używa już znaczników rel="next" i rel="prev". Dokumentacja stwierdza to jednoznacznie i dodaje, że inne wyszukiwarki nadal mogą z takich linków korzystać. Znaczniki te umieszczano w sekcji head, aby wskazać poprzednią i następną stronę sekwencji.
Dla właściciela serwisu wynikają z tego dwa wnioski. Po pierwsze, znaczników nie trzeba usuwać, bo nie szkodzą. Po drugie, nie wolno na nich polegać. Serwis, który ma poprawne znaczniki w nagłówku, ale nawigację na przyciskach bez atrybutu href, pozostaje dla Google nieczytelny.
Miejsce dawnego sygnału zajęły trzy rzeczy opisane wyżej: unikalne adresy, adres kanoniczny wskazujący na tę samą stronę oraz odnośniki w treści strony. Google deklaruje, że sam stara się rozpoznać, iż strony tworzą sekwencję. Cała konfiguracja sprowadza się więc do tego, żeby mu tego nie utrudniać.
| Element | Zalecane ustawienie | Częsta pomyłka |
|---|---|---|
| Adres strony | Numer w parametrze lub w ścieżce | Numer po znaku krzyżyka |
| Adres kanoniczny | Wskazuje na tę samą stronę | Wskazuje na pierwszą stronę listy |
| Nawigacja | Elementy a z atrybutem href | Przyciski obsługiwane tylko skryptem |
| Tag robots | Brak zakazu indeksowania | Noindex dodany bez zapewnienia innych dojść do treści |
| Znaczniki next i prev | Mogą zostać, ale nie są podstawą | Traktowanie ich jako jedynego sygnału |
| Sortowanie i filtry | Noindex lub blokada w robots.txt | Pozostawienie wszystkich wariantów w indeksie |
Tytuły, opisy i treść na kolejnych stronach
Na wszystkich stronach sekwencji można użyć tych samych tytułów i opisów. Google przyznaje, że zwykle zaleca unikalne tytuły, ale w tym przypadku stara się rozpoznać sekwencję samodzielnie, więc powtórzenie nie jest błędem. Komunikat o zduplikowanych tytułach, który często pojawia się w automatycznych raportach z przeglądu serwisu, w odniesieniu do stron listy nie wymaga zatem pilnej reakcji.
Mimo to z naszej praktyki wynika, że krótki dopisek z numerem strony w tytule, na przykład „Aktualności - strona 3”, ułatwia pracę. Porządkuje raporty w Search Console i podpowiada czytelnikowi, w którym miejscu listy się znalazł, gdy otworzy kilka kart naraz.
Więcej uwagi wymaga tekst wprowadzający. Jeśli kategoria bloga albo dział realizacji ma opis nad listą, powtarzanie go w całości na każdej kolejnej stronie powiela ten sam blok treści na wielu adresach. Rozsądnym rozwiązaniem jest wyświetlanie opisu tylko na stronie pierwszej, która dzięki temu wyraźnie odróżnia się od pozostałych. To nasza rekomendacja, nie wymóg z dokumentacji. O samym opisie piszemy we wpisie o stronie kategorii bloga.
Pozycje listy powinny być prawdziwymi odnośnikami z opisowym tekstem, najlepiej tytułem wpisu lub realizacji. Google radzi, by tekst odnośnika był zrozumiały bez kontekstu, a ogólnikowy zwrot „czytaj dalej” jako jedyne łącze do wpisu tego warunku nie spełnia.
Paginacja w blogu, archiwach, na forum i w realizacjach
W serwisach innych niż sklep obowiązują te same zasady techniczne, ale inne są miejsca, w których podział na strony powstaje, i inne ryzyka. Poniżej omawiamy cztery najczęstsze przypadki.
Blog i dział aktualności
WordPress dzieli listy wpisów automatycznie. Według dokumentacji dla twórców motywów domyślnie pokazuje 10 wpisów na stronie w kategoriach, archiwach i na stronie głównej bloga, a liczbę tę zmienia się w panelu, w menu Ustawienia, na ekranie Czytanie. Za nawigację odpowiada motyw: funkcja the_posts_pagination() wyświetla numerowane odnośniki, a next_posts_link() i previous_posts_link() same łącza do starszych i nowszych wpisów.
W blogu ten sam wpis trafia zwykle na kilka list jednocześnie: główną, kategorii, tagów, autora i archiwum miesięcznego. Każda z nich jest stronicowana osobno, więc liczba adresów list szybko rośnie. Warto zdecydować, które z nich są potrzebne czytelnikom. Kategorie zwykle tak. Archiwa dat i archiwum jedynego autora na ogół powielają listę główną i to one, a nie dalsze strony kategorii, są kandydatami do wyłączenia.
Druga kwestia to głębokość. Jeśli nawigacja pokazuje wyłącznie łącza „starsze” i „nowsze”, dawny wpis może leżeć kilkadziesiąt przejść od strony głównej. Numerowana nawigacja z odnośnikami do kilku sąsiednich stron oraz do pierwszej i ostatniej skraca tę drogę, podobnie jak odnośniki między powiązanymi wpisami.
Jeden wpis podzielony na strony
WordPress pozwala podzielić pojedynczy wpis na części znacznikiem <!--nextpage--> wstawionym w treść, a odnośniki do części wyświetla funkcja wp_link_pages(). Dzielona jest tu treść, a nie lista, ale każda część ma własny adres i podlega tym samym regułom. Długi tekst ze spisem treści i kotwicami bywa dla czytelnika wygodniejszy, a cała jego treść znajduje się wtedy pod jednym adresem.
Forum i komentarze
Na forum podział występuje na dwóch poziomach: lista wątków w dziale oraz odpowiedzi w obrębie jednego wątku. Długie dyskusje mają dziesiątki stron, a wartościowa odpowiedź może znajdować się na którejkolwiek z nich. To najlepszy przykład, dlaczego adres kanoniczny nie może wskazywać pierwszej strony: treść odpowiedzi ze strony piątej nie występuje nigdzie indziej. Podobnie działają stronicowane komentarze pod wpisami na blogu, które Google wymienia wśród zastosowań podziału na strony.
Realizacje, ogłoszenia, katalogi
Firma usługowa często pokazuje realizacje w postaci galerii z przyciskiem doładowania kolejnych pozycji. Dla przykładu: biuro projektowe z Kielc ma na stronie sto dwadzieścia opisów realizacji, z których przy wejściu widać dwanaście, a reszta dokłada się po kliknięciu przycisku bez zmiany adresu. Jeśli do pozostałych opisów nie prowadzi żaden zwykły odnośnik, robot może ich w ogóle nie odnaleźć. Rozwiązaniem jest przycisk zbudowany jako element a z adresem następnej strony, który skrypt jedynie przechwytuje, albo klasyczna numeracja pod galerią.
Jak sprawdzić ustawienia we własnym serwisie
Ustawienia sprawdza się w dwóch miejscach: w kodzie źródłowym drugiej lub trzeciej strony listy oraz w Search Console, w narzędziu do sprawdzania adresów URL i w raporcie Indeksowanie stron. Nie wymaga to dodatkowego oprogramowania.
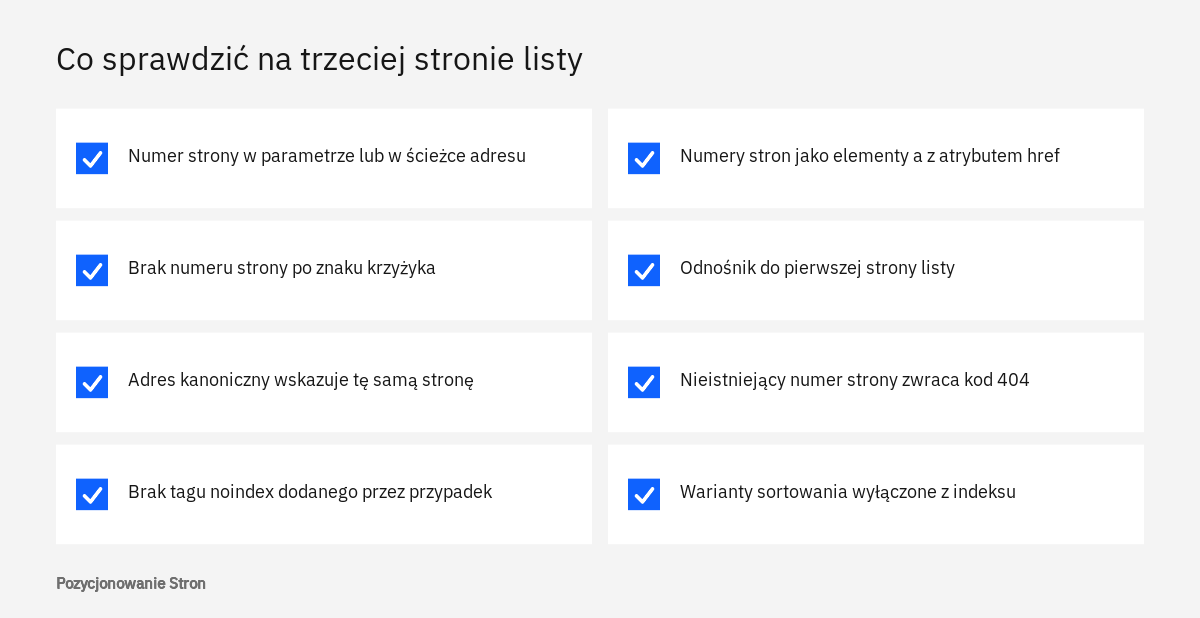
Pierwszy etap odbywa się w przeglądarce. Należy otworzyć trzecią stronę dowolnej listy, wyświetlić źródło strony i odszukać w sekcji head wiersz z rel="canonical" oraz znacznik meta robots. Następnie warto odnaleźć w kodzie nawigację między stronami i sprawdzić, czy numery są elementami a z atrybutem href.
Drugi etap to Search Console. Adres trzeciej strony listy wkleja się w pole wyszukiwania u góry ekranu. W wyniku znajdują się pola „Adres kanoniczny określony przez użytkownika” i „Adres kanoniczny wybrany przez Google”. Przy poprawnej konfiguracji oba pokazują adres sprawdzanej strony. Pole „Strona odsyłająca” podpowiada, skąd robot dowiedział się o adresie, a pola „Czy skanowanie jest dozwolone” i „Czy indeksowanie jest dozwolone” ujawniają blokadę w robots.txt lub tag noindex. Jeżeli lista jest składana skryptem, warto użyć przycisku testu wersji opublikowanej i obejrzeć wyrenderowany kod HTML: powinny się w nim znajdować pozycje listy i odnośniki do sąsiednich stron. Obsługę tego narzędzia opisujemy we wpisie o sprawdzaniu adresu URL w Search Console.
Trzeci etap to raport Indeksowanie stron, a w nim tabela „Dlaczego strony nie są indeksowane”. Według pomocy Search Console status „Alternatywna strona zawierająca prawidłowy tag strony kanonicznej” oznacza, że strona wskazuje inny adres jako kanoniczny. Jeśli po kliknięciu tego wiersza na liście widać adresy z numerami stron, canonical najpewniej kieruje na początek listy. Status „Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik” sygnalizuje, że Google nie zgodził się z deklaracją. „URL zawiera tag noindex” pokaże strony wyłączone, być może bez wiedzy właściciela, przez ustawienie wtyczki.
- Każda strona listy ma własny adres z numerem w parametrze albo w ścieżce, bez znaku krzyżyka.
- Adres kanoniczny strony drugiej i dalszych wskazuje na tę samą stronę i jest zapisany jako pełny adres.
- Pierwsza strona jest dostępna pod jednym adresem, a wersja z numerem jeden do niego przekierowuje.
- Numery stron i łącze do następnej strony są elementami a z atrybutem href.
- Z każdej strony prowadzi odnośnik do pierwszej strony listy.
- Dalsze strony nie mają tagu noindex, chyba że jest to świadoma decyzja.
- Nieistniejący numer strony zwraca kod 404.
- Warianty sortowania i filtry są wyłączone z indeksu albo ze skanowania.
Kiedy potrzebna jest pomoc specjalisty
W małym blogu na WordPressie poprawki sprowadzają się zwykle do ustawień wtyczki SEO i drobnej zmiany w motywie. Wsparcie przydaje się, gdy lista jest budowana skryptem w przeglądarce, gdy serwis ma tysiące stron list z filtrami albo gdy błędna konfiguracja działała długo i trzeba zaplanować jej odwrócenie. Takie prace wykonujemy w ramach SEO technicznego, a przegląd list, parametrów i adresów kanonicznych jest częścią audytu SEO. W sklepach, gdzie dochodzą filtry i dane produktowe, zakres jest szerszy i obejmuje go pozycjonowanie sklepów. Po zmianach wyszukiwarka musi ponownie odwiedzić strony, a tempa tego procesu nie da się zagwarantować.
Jeśli chcą Państwo zamówić pozycjonowanie sklepu internetowego, zachęcamy do kontaktu: tel. 222 500 844 lub mailowo: biuro@pozycjonowaniestron.pl
Najczęstsze pytania
Czy strony 2, 3 i dalsze powinny być w indeksie Google?
Dokumentacja Google nie zaleca ich wyłączania, a tag noindex wymienia tylko przy wariantach sortowania i filtrach. Dalsze strony są drogą robota do starszych treści, dlatego bezpieczniej jest zostawić je indeksowalne.
Czy adres kanoniczny drugiej strony może wskazywać pierwszą?
Nie powinien. Google wprost odradza używanie pierwszej strony sekwencji jako kanonicznej dla pozostałych i zaleca, by każda strona miała własny adres kanoniczny. Strona druga pokazuje inne pozycje niż pierwsza, więc nie jest jej kopią.
Czy trzeba usunąć znaczniki rel next i rel prev?
Nie ma takiej potrzeby. Google już ich nie używa, ale według dokumentacji inne wyszukiwarki nadal mogą z nich korzystać. Podstawą połączenia między stronami pozostają zwykłe odnośniki w treści strony.
Czy powtarzające się tytuły na kolejnych stronach to błąd?
Nie. Google dopuszcza te same tytuły i opisy na wszystkich stronach sekwencji, ponieważ stara się rozpoznać ją samodzielnie. Dopisek z numerem strony jest wygodny w raportach, ale nie jest wymagany.
Czy przewijanie nieskończone szkodzi widoczności?
Samo w sobie nie, pod warunkiem że każda porcja treści ma własny trwały adres i prowadzą do niej zwykłe odnośniki. Robot Google nie klika przycisków, więc bez takich adresów może widzieć tylko pierwszą porcję listy.
Ile wpisów wyświetlać na jednej stronie listy?
Google nie podaje zalecanej liczby. WordPress domyślnie pokazuje 10 wpisów, co można zmienić w ustawieniach czytania. Większa liczba skraca drogę do starszych treści, ale wydłuża wczytywanie strony.
Źródła
- Podział na strony, przyrostowe wczytywanie stron i ich wpływ na wyszukiwarkę Google, Centrum wyszukiwarki Google
- Jak określić kanoniczny URL za pomocą rel="canonical" i innych metod, Centrum wyszukiwarki Google
- Sprawdzone metody dotyczące linków i SEO, Centrum wyszukiwarki Google
- Blokowanie indeksowania przez wyszukiwarki za pomocą tagu noindex, Centrum wyszukiwarki Google
- Naprawianie leniwie ładującej się zawartości, Centrum wyszukiwarki Google
- Optymalizacja budżetu indeksowania, Google for Developers
- Narzędzie do sprawdzania adresów URL, Search Console - pomoc
- Raport Indeksowanie stron, Search Console - pomoc
- Pagination - Theme Handbook, WordPress.org
Funkcje wyszukiwarek i asystentów AI zmieniają się szybko, dlatego wpis aktualizujemy po większych zmianach.